Unternehmens-AI-Infrastruktur und Bereitstellungsstrategien
Die Unternehmens-AI-Infrastruktur und Bereitstellungsstrategien stehen im Mittelpunkt der modernen digitalen Transformation. Sie richtig zu gestalten trennt Piloten von der Produktion, senkt die Kosten und schützt Daten. Unternehmen stehen vor Entscheidungen über On-Premises-, Cloud- und Edge-Computing. Beispielsweise verändern Azure-Verpflichtungen und -Partnerschaften die Kapazitätsplanung und Beschaffung.
Allerdings wird die Inferenz anstelle des Trainings oft zum tatsächlichen betrieblichen Engpass. Daher müssen Teams für Inferenzskalierung, Latenz und Kosten pro Abfrage entwerfen. Datenschutz- und Wohnsitzregeln machen Architekturentscheidungen in verschiedenen Regionen komplexer. Infolgedessen gewinnen hybride Modelle, private Clouds und regionale Inferenzknoten an Bedeutung.
Werkzeuge wie retrieval augmented generation und Modellkontextprotokolle verändern auch die Bereitstellungsmuster. In diesem Leitfaden analysieren wir Muster, Kompromisse und praktische Schritte zur Implementierung. Aufgrund der Skalierung behandeln wir Speicher-, Netzwerk- und GPU-Wahl. Wir erklären Kostenoptimierung und Governance-Kontrollen. Wir heben Fallstudien aus der Industrie und der Wissenschaft hervor. Sie werden lernen, wie man ROI misst und Modelle operationalisiert.
Lesen Sie weiter für umsetzbare Rahmenwerke, Checklisten und Bereitstellungsmuster.
Unternehmens-AI-Infrastruktur und Bereitstellungsstrategien: Warum robuste Infrastruktur wichtig ist
Eine widerstandsfähige Infrastruktur ist die Grundlage jedes erfolgreichen AI-Programms. Unternehmen benötigen Rechenleistung, Speicherung und Netzwerke, die mit der Nachfrage skalieren. Viele Teams betrachten die Infrastruktur jedoch nur als nachträgliche Überlegung. Infolgedessen kommen Pilotprojekte ins Stocken, wenn sie auf Produktionslatenz- oder Kostenlimits stoßen. Daher müssen Organisationen von Anfang an für Inferenzskalierung, Datenresidenz und Governance planen.
Wichtige strategische Überlegungen
- Die Architektur mit den Geschäftsergebnissen in Einklang bringen, da ROI die Akzeptanz und Finanzierung antreibt.
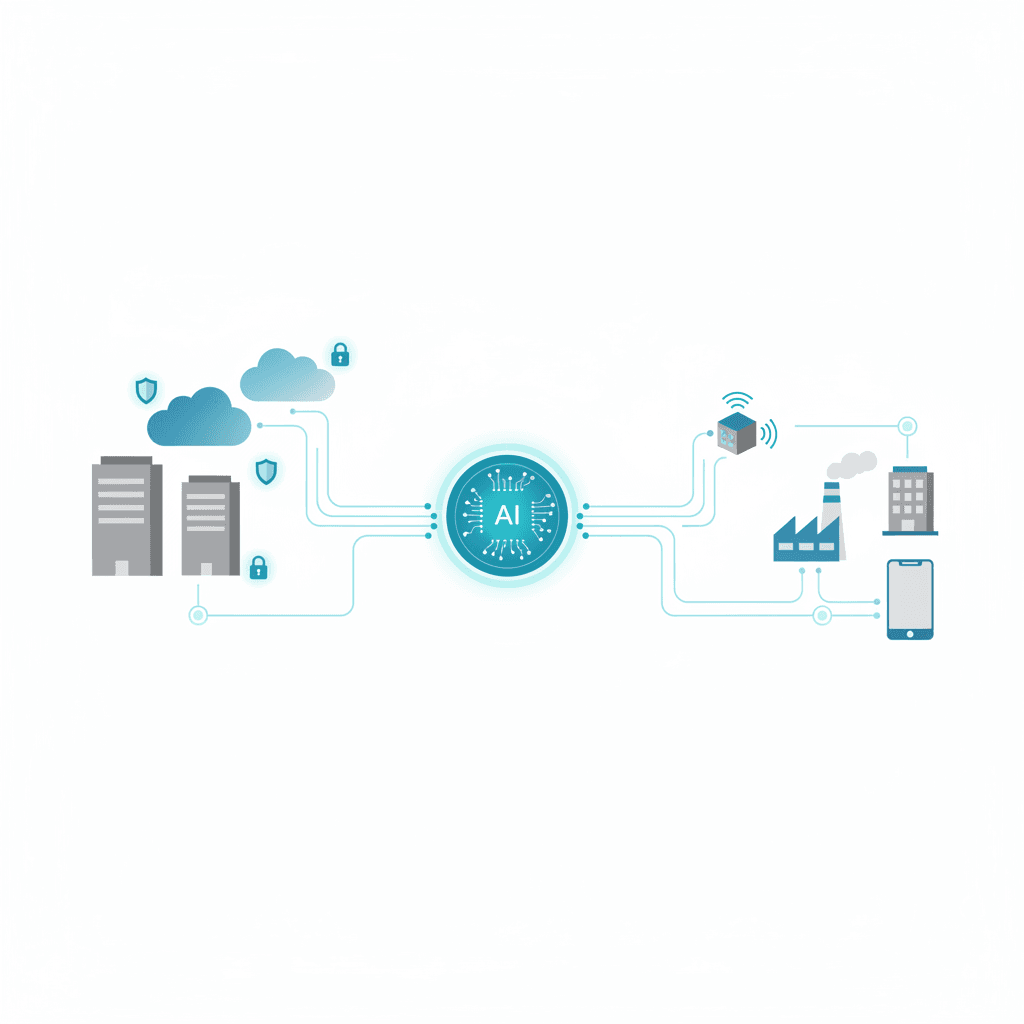
- Die richtige Mischung aus Cloud, On-Premises und Edge wählen, um Latenz- und Souveränitätsbedürfnisse zu erfüllen.
- Für Inferenzeffizienz planen, da Inferenz oft teurer ist als das Training.
- Beobachtbarkeit und CI/CD-Pipelines aufbauen, um Modelle zuverlässig von Experimenten in die Produktion zu überführen.
- Daten mit Verschlüsselung, unveränderlichen Snapshots und Replikation schützen, um die Compliance zu gewährleisten.
Warum das jetzt wichtig ist
Cloud- und Anbieterkollaborationen verändern die Kapazitätsplanung. Zum Beispiel erweitern Anthropic und Cloud-Partnerschaften das regionale Angebot und verändern die Beschaffungsdynamik. Für technische Hinweise siehe die Microsoft Foundry-Dokumentation unter Microsoft Foundry-Dokumentation. Für den Branchenkontext zu Rechenverpflichtungen lesen Sie die AP News-Zusammenfassung unter AP News-Zusammenfassung.
Praktische nächste Schritte
Beginnen Sie mit einer Lückenanalyse der aktuellen Infrastruktur. Priorisieren Sie dann Latenzpfade mit hoher Priorität und Edge-Knoten, an denen Benutzer Echtzeitantworten benötigen. Für einen kompakten Überblick über Bereitstellungsmuster konsultieren Sie diese eingehende Übersicht: Überblick über Unternehmens-AI-Infrastruktur-Bereitstellungsstrategien.
Verwandte Schlüsselwörter und Konzepte: Latenz, Inferenz, Edge-Computing, Datenhoheit, NVLink, hybride Cloud, RAG, MCP.
Warum Nachweise wichtig sind: Beweise, dass Infrastruktur Ergebnisse verändert
Unternehmen, die in skalierbare KI-Infrastruktur investieren, sehen schnellere Wertschöpfung. Beispielsweise erweitern strategische Cloud- und Anbieterallianzen die Kapazität und reduzieren Beschaffungsfriktionen. AP News berichtet, dass Anthropic sich verpflichtet hat, 30 Milliarden Dollar an Azure-Computerkapazität zu kaufen, was auf das Interesse größerer Akteure an Kapazitätsplanung und regionalen Lieferketten hinweist. Ganze Geschichte: AP News.
Expertenperspektiven
- Jensen Huang, CEO von NVIDIA, betrachtet KI als eine Form kritischer Infrastruktur. Er sagte: “KI ist jetzt Infrastruktur, und diese Infrastruktur, genau wie das Internet, genau wie Elektrizität, benötigt Fabriken.” Siehe NVIDIA-Blog.
- Branchenanalysten stellen fest, dass viele KI-Projekte vor der Produktion ins Stocken geraten. Folglich müssen Teams die Lücke zwischen Experimentierung und Bereitstellung schließen, um Wert zu schaffen. Beispielsweise stellt BCG fest, dass nur 26 Prozent der Unternehmen die Fähigkeiten haben, über Machbarkeitsstudien hinauszugehen. Lesen Sie BCG.
Konkrete Beispiele und Ergebnisse
- NTT und tsuzumi 2: NTT hat tsuzumi 2 veröffentlicht, ein japanisches LLM, das auf einer einzigen GPU läuft. Daher können Organisationen wie die Tokyo Online University Modelle vor Ort oder in privaten Clouds bereitstellen. Details: NTT-Pressemitteilung.
- Hardware-Fortschritte: NVIDIA’s Grace Blackwell mit NVLink verspricht erhebliche Geschwindigkeitsgewinne. Daher verbessern sich Inferenzlatenz und Token-Ökonomie für hochdurchsatzfähige Workloads. Hintergrund: Artificial Intelligence News.
Wichtige Erkenntnisse
- Robuste Infrastruktur senkt Betriebskosten und Latenz. Somit beschleunigt sie die Produktionsrollouts.
- Hybrid- und Edge-Bereitstellungen reduzieren das Risiko von Datenresidenzen und senken die Inferenzkosten in Zielregionen.
- Da Skalierung Menschen und Prozesse betrifft, investieren Sie frühzeitig in CI CD, Überwachung und Governance.
Verwandte Konzepte: Inferenz-Effizienz, Datensouveränität, Hybrid-Cloud, NVLink, RAG, KI-Liefernetzwerke.
| Strategie | Kosten | Skalierbarkeit | Implementierungskomplexität | Sicherheit | Typische Anwendungsfälle |
|---|---|---|---|---|---|
| Öffentliche Cloud | Niedrigere einmalige Kosten, höhere laufende OpEx | Sehr hoch, elastisch für Spitzenlasten | Einfach zu starten, schnelle Bereitstellung | Modell der geteilten Verantwortung, starke verwaltete Kontrollen | Trainingsskalen, SaaS-Integrationen, Burst-Inferenz |
| Private Cloud oder vor Ort | Hohe Investitionskosten, niedrigere langfristige OpEx | Moderat, durch lokale Hardware eingeschränkt | Komplexe Einrichtung und Beschaffung | Hohe Kontrolle über Daten und Aufenthaltsort | Regulierte Industrien, sensible Datenlasten |
| Hybride Cloud | Ausgewogene CapEx und OpEx | Hoch, wenn richtig integriert | Moderat, erfordert Orchestrierungswerkzeuge | Mischung aus Cloud-Kontrollen und vor Ort Kontrollen | Schrittweise Cloud-Migration, RAG mit privaten Daten |
| Edge- und verteilte Inferenz | Niedrigere regionale OpEx, Hardwarekosten variieren | Skaliert horizontal nach Standort | Komplex, benötigt Gerätemanagement | Stark hinsichtlich Latenz und Datenaufenthaltsort | Echtzeit-IoT, Einzelhandelsinferenz, latenzempfindliche Anwendungen |
| Multi-Cloud-Föderation | Variable Kosten, potenziell höhere Netzwerkgebühren | Hoch, aber operationell komplex | Komplex, benötigt Föderationswerkzeuge | Hängt von Anbietern und Governance ab | Anbieterredundanz, geografische Resilienz, regulatorische Diversität |
Wichtige Kompromisse und Empfehlungen:
- Priorisieren Sie die Inferenzeffizienz, da die Inferenz die laufenden Kosten antreibt. Optimieren Sie daher die Modellgröße und das Batching.
- Wählen Sie hybride oder Multi-Cloud, wenn Datensouveränität und Latenz entscheidend sind. Dies balanciert Skalierbarkeit mit Kontrolle.
- Investieren Sie frühzeitig in Orchestrierung, CI CD und Observierbarkeit. Andernfalls wird die operationale Komplexität die Akzeptanz verlangsamen.
Verwandte Schlüsselwörter: Edge-Computing, Latenz, Inferenz, Datensouveränität, hybride Cloud, NVLink, RAG.
FAZIT
Eine starke Infrastruktur für KI im Unternehmen und Bereitstellungsstrategien bestimmen, ob KI geschäftlichen Wert liefert. Kurz gesagt, wählen Sie Architekturen, die Ihren Anforderungen an Latenz, Souveränität und Kosten entsprechen. Hybride und Edge-Modelle balancieren Kontrolle und Skalierung. Die öffentliche Cloud beschleunigt Experimente, während private Clouds sensible Daten schützen. Daher sollten Entscheidungsträger Anwendungsfälle vor schweren Investitionen den Bereitstellungsmustern zuordnen.
Da die Inferenz die Betriebskosten beeinflusst, optimieren Sie Modelle und Bereitstellungen für eine effiziente Inferenz. Investieren Sie frühzeitig in Orchestrierung, CI CD, Monitoring und Governance. Infolgedessen vermeiden Teams die häufige Falle, dass Pilotprojekte vor der Produktion ins Stocken geraten. Berücksichtigen Sie auch Partnerschaften mit Anbietern und regionale Kapazitätsverpflichtungen bei der Planung von Beschaffung und Resilienz.
AllosAI hilft Unternehmen, KI in großem Maßstab in den Betrieb zu integrieren. Die Plattform bietet Lösungen für externe Chatbots auf Unternehmensniveau, Lead-Erfassung, CRM-Integration und KI-gestützte Kundenbindungs-Tools. Besuchen Sie die Website, um mehr zu erfahren unter AllosAI. Probieren Sie die Plattform unter AllosAI Platform aus. Erkunden Sie das Wissenszentrum unter AllosAI Blog. Verfolgen Sie Updates auf X unter Hey AllosAI.
Gehen Sie den nächsten Schritt, indem Sie Ihre Infrastrukturentscheidungen mit klaren Geschäftsergebnissen in Einklang bringen. Experimentieren Sie schnell, aber entwerfen Sie von Anfang an für die Produktion. Kontaktieren Sie Anbieter und Pilotpartner mit einem Fokus auf Inferenzökonomie und Daten-Governance. Skalieren Sie dann mit Zuversicht in Richtung messbaren ROI.
Häufig gestellte Fragen (FAQs)
Welches Bereitstellungsmodell sollte mein Unternehmen wählen?
Beginnen Sie damit, Geschäftsergebnisse und Benutzerbedürfnisse zu ermitteln. Da Latenz, Datenlagerung und Kosten je nach Anwendungsfall variieren, wählen Sie das Modell, das diesen Einschränkungen entspricht. Für Echtzeitanwendungen wählen Sie Edge- oder Hybridbereitstellungen. Bei intensivem Training oder Burst-Inferenz verwenden Sie die öffentliche Cloud. Für regulierte Daten ziehen Sie die private Cloud oder lokale Lösungen vor.
Wie kann ich die Inferenzkosten senken?
Optimieren Sie Modelle durch Quantisierung und Beschneidung. Bündeln Sie auch Anfragen und verwenden Sie serverseitiges Caching. Erwägen Sie einzelne GPU-Modelle wie tsuzumi 2 für kleine bis mittlere Arbeitslasten. Bewerten Sie schließlich die Kosten pro Anfrage im Zusammenhang mit den SLA-Anforderungen.
Wie erfülle ich die Anforderungen an Datenhoheit und Compliance?
Verwenden Sie regionale Inferenzknoten und die private Cloud für sensible Daten. Verschlüsseln Sie Daten im Ruhezustand und während der Übertragung. Halten Sie außerdem unveränderliche Snapshots und Replikationen für die Nachvollziehbarkeit bereit. Koordinieren Sie frühzeitig rechtliche, sicherheitsrelevante und plattformspezifische Teams.
Welche Tools und Prozesse beschleunigen Produktionsbereitstellungen?
Übernehmen Sie CI CD für Modelle, Modellregistrierungen und Observierbarkeit. Verwenden Sie Orchestrierungsplattformen wie Kubernetes. Automatisieren Sie auch Tests, Canary-Releases und Rollback-Verfahren.
Wie sollten wir den Erfolg messen?
Überwachen Sie Latenz, Kosten pro Anfrage, Genauigkeit, Verfügbarkeit und geschäftliche KPIs. Führen Sie Pilotbenchmarks durch und messen Sie dann die tatsächliche Rentabilität. Iterieren Sie dann basierend auf der operativen Telemetrie.
